Своя нейросеть за вечер: что нужно, сколько весит и где подвох
Ставим языковую модель на свой компьютер: какое железо нужно, какую модель взять, почему она «тормозит» и как случайно не раздать её всему интернету.
Своя языковая модель — это не проект на квартал с закупкой серверов. Первую можно поставить за вечер на обычный компьютер. Она будет скромнее самых больших облачных, зато твой текст никуда не уйдёт, а доступ не отключат в день дедлайна.
Ниже — короткий путь и три места, где обычно спотыкаются.
Что нужно
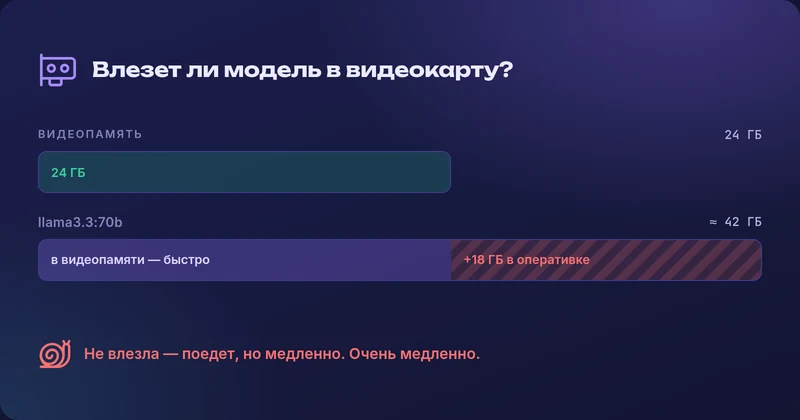
Видеокарта с памятью — главный ресурс. Модель должна целиком поместиться в видеопамять (VRAM), тогда она отвечает быстро. Не поместилась — часть уедет в оперативную память, и всё заработает, но заметно медленнее.
Ориентиры для моделей в сжатом виде (квантование Q4 — стандарт по умолчанию, качество почти не страдает):
| Размер модели | Весит примерно | Что нужно |
|---|---|---|
| 3–4B | 2,5 ГБ | Любая видеокарта от 4 ГБ, терпимо даже на процессоре |
| 7–8B | 5 ГБ | Видеокарта 8 ГБ |
| 14B | 9 ГБ | Видеокарта 12 ГБ |
| 32B | 20 ГБ | Видеокарта 24 ГБ |
| 70B | 40+ ГБ | Две большие видеокарты или сервер |
К весу модели добавь 1–3 ГБ на окно контекста — «рабочую память» для твоего текста. Чем длиннее документ, тем больше.
На компьютерах Mac с чипами Apple память общая для процессора и графики, поэтому там помещаются модели крупнее, чем подсказывает таблица.
Ставим
Самый простой вариант — Ollama: программа, которая скачивает модели и отдаёт их другим приложениям.
- Скачай установщик с официального сайта (Windows, macOS) или поставь на Linux по инструкции оттуда же. На Linux инструкция предлагает
curl … | sh— то есть запустить скрипт из интернета, не читая. Удобно. Прочитай хотя бы по диагонали: он ставит программу в систему. - Скачай и запусти модель одной командой:
ollama run qwen3:8b. Первый раз скачается около 5 ГБ, потом прямо в терминале можно разговаривать. - Полезные команды:
ollama list— что скачано,ollama ps— что сейчас загружено в память и сколько места занимает.
Модели удобно сравнивать на своих задачах: возьми три-четыре реальных примера (письмо, выжимка из документа, вопрос по твоей теме) и прогони через пару моделей. Рейтинги в интернете — про чужие задачи.
Подвох 1: «она тормозит»
Почти всегда одно из трёх:
- Модель не влезла в видеопамять. Посмотри
ollama ps: если там часть на CPU — бери модель поменьше или сжатие сильнее. - Первый запрос. Модель грузится в память — для больших это может быть минута. Дальше быстрее. Чтобы не выгружалась между запросами, у Ollama есть настройка
OLLAMA_KEEP_ALIVE. - «Думающая» модель. Некоторые модели сначала долго рассуждают про себя и только потом отвечают. Это не зависание, это размышления — их просто не всегда показывают.
Подвох 2: «она забывает начало»
У Ollama по умолчанию небольшое окно контекста. Длинный документ в него не помещается, и начало тихо отрезается — модель не жалуется, она просто отвечает по тому, что осталось. Окно можно увеличить параметром num_ctx (ценой видеопамяти). Хорошие приложения делают это за тебя или режут документ на куски сами.
Подвох 3: «сделаем доступ с других компьютеров»
По умолчанию Ollama слушает только сам компьютер (127.0.0.1) — и это правильно. Чтобы подключаться с ноутбука, её переключают на OLLAMA_HOST=0.0.0.0, то есть «на всех сетевых интерфейсах». Дальше начинается самое интересное.
У Ollama нет пароля. Кто может достучаться до порта 11434, тот может пользоваться моделью, смотреть список моделей, скачивать новые и занимать твою видеокарту. Если компьютер доступен из интернета — например, порт проброшен на роутере «ненадолго, чтобы с телефона попробовать», — «кто может достучаться» означает «кто угодно». Поисковики по открытым портам находят такие серверы тысячами.

Как открыть доступ и не открыть его всем:
- Разреши порт только своей подсети в брандмауэре, а не «всем» (в Windows: правило для порта 11434 с удалённым адресом вроде
192.168.1.0/24). - Никогда не пробрасывай порт модели на роутере. Нужен доступ снаружи — VPN до своей сети или обратный прокси с HTTPS и ключом.
- Если сервер модели виден только с одного компьютера, а пользоваться нужно с нескольких — поставь на этот компьютер посредника вроде ZmNx Relay: он отвечает только локальной сети.
Дальше
Терминал — чтобы попробовать. Для работы удобнее приложение: история чатов, работа с документами, выбор модели под задачу. Мы для этого делаем ZmNx·AI — оно подключается к Ollama, LM Studio и другим серверам, само выставляет окно контекста и подсвечивает, если адрес сервера вдруг оказался не твоим.
А главное правило то же, что и с облачными моделями: модель уверенно ошибается. Своя — ошибается приватно, но проверять всё равно придётся.